ChatGPT wählt seine Quellen nicht wie eine Suchmaschine aus: Fakten wie Preise zitiert es von der Seite einer Brand, sofern sie dort als Text stehen, das Urteil holt es von Dritten. Das zeigt eine Analyse, für die der Mitgründer der Agentur Snippet Digital im Juni 2026 rund 1.240 Quell-Einträge aus dem Netzwerkverkehr seines bezahlten Kontos ausgewertet hat. Drei von zehn bewusst aktuell formulierten Fragen lösten keine Websuche aus, Reddit wurde 278-mal abgerufen und 11-mal zitiert, YouTube 201-mal abgerufen und nie zitiert. Spätere Daten bis September 2026 bestätigen die Mechanik, nicht aber alle Häufigkeiten: Größere Messungen finden durchaus YouTube-Zitate, der Reddit-Anteil schwankt. Für deine Brand heißt das: Preise und Konditionen gehören als HTML-Text auf die eigene Seite, über die Empfehlung entscheiden Drittquellen mit.
Ist ChatGPT eine Suchmaschine?
Nein. ChatGPT gibt keine Trefferliste aus wie eine Suchmaschine, sondern entscheidet in Stufen: ob es überhaupt sucht, über welchen Abrufweg (Pipeline) es Quellen holt und welche davon es zitiert. So beschreibt es die Analyse, die der Mitgründer von Snippet Digital am 24. Juni 2026 in seinem Blog veröffentlicht hat, zugespitzt auf den Satz „ChatGPT isn't a search engine, so stop optimising for one.“ Wer ChatGPT wie eine Suchmaschine behandelt, optimiert also am System vorbei.
Im Network-Tab der Chrome-DevTools, den Entwicklerwerkzeugen des Browsers, hat der Autor die JSON-Daten gelesen, die ChatGPT dorthin schickt. Die Daten stammen aus einigen Dutzend Suchen auf einem bezahlten Konto, erhoben am 23. und 24. Juni 2026. Jeder Quell-Eintrag trug interne Labels, die im Chat nicht zu sehen waren:
{
  "attribution": "TechRadar",
  "url": "techradar.com/best/…",
  "pub_date": "2026-05-09",
  "result_source": "labrador"
}- Quell-Einträge aus einigen Dutzend Suchen
- rund 1.240
- Werte im Feld result_source, also Abrufwege (Pipelines)
- 4
- Werte im Feld turn_use_case je Frage, also Frage-Typen
- 6
Lesbar waren außerdem ChatGPTs eigene Suchanfragen und die gespeicherte Begründung des Thinking-Modells, also seine Denkschritte vor der Antwort. Einen Ranking-Score oder eine Formel zeigte der Netzwerkverkehr im Juni nicht.
Wann sucht ChatGPT im Web und wann nicht?
ChatGPT ordnete im Juni jede Frage zuerst einem Frage-Typ zu (Feld turn_use_case), und nur ein Teil dieser Typen löste eine Websuche aus. Beim Typ text antwortete ChatGPT aus dem Trainingskorpus, der Network-Tab blieb leer. Auch drei von zehn bewusst aktuell formulierten Fragen liefen ohne jede Websuche, darunter die nach den neuesten Behandlungsleitlinien für Typ-2-Diabetes.
- text
- instant_search
- shopping
- local
- thinking
- image_gen
- „latest treatment guidelines for type 2 diabetes“
- „how to change a flat tyre“
- Python-Funktion für zwei sortierte Listen
- „best 4K TVs with reviews“ normale Suche
- „best 4K TVs to buy“ shopping
- „best coffee near me“ local
- „Tesla stock price this week“ instant_search
Laut dem Autor entschied die Formulierung über den Frage-Typ, nicht das Thema. Seine eigenen Beispiele, nach seinen Worten aus begrenzten Tests, zeigen aber Ausnahmen: „best earbuds to buy“ landete bei instant_search, der schnellen Websuche, „best CRM to buy“ bei shopping.
Welche Quellen nutzt ChatGPT?
ChatGPT holt Suchergebnisse nicht aus einem einzigen Index, sondern über mehrere Abrufwege, sogenannte Pipelines. Im Juni wies das Feld result_source an jedem Quell-Eintrag vier davon aus: serp, labrador, bright und oxylabs. Hinter bright und oxylabs vermutete der Autor, allein aus den Feldnamen, die Scraping-Dienstleister Bright Data und Oxylabs.
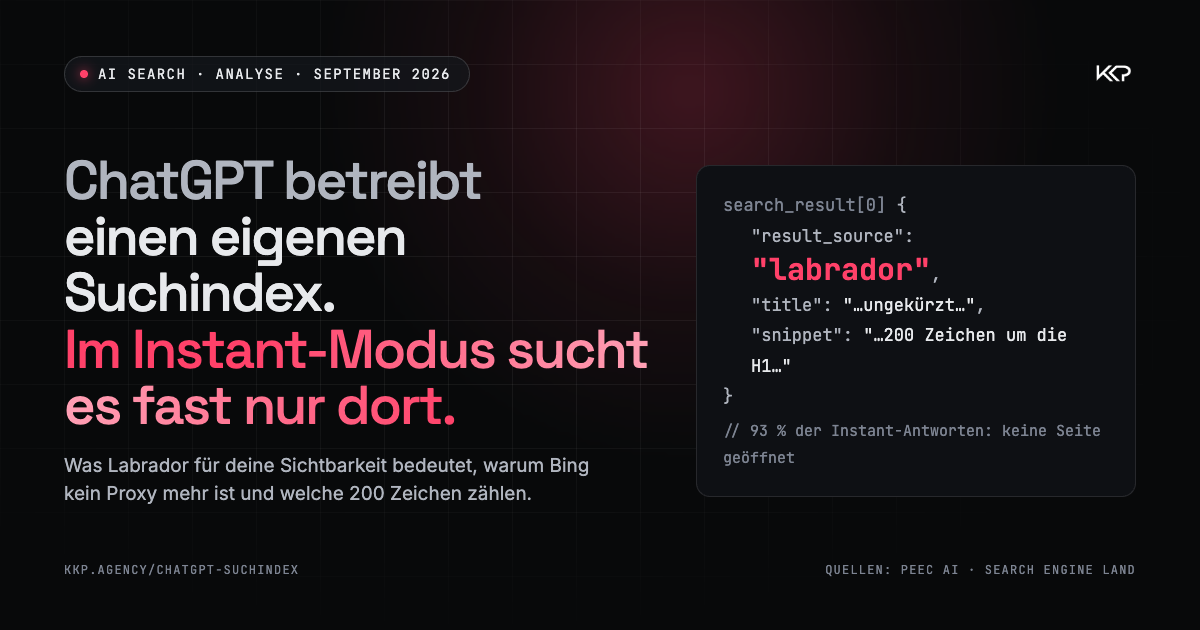
Nach der Lesart vom Juni war labrador eine Positivliste etablierter Publisher wie Reuters, Wall Street Journal, Wikipedia und arXiv, eine Art „lizenzierte Publisher-Stufe“. Welche Pipeline griff, hing in der Stichprobe vom Thema der Frage ab: bright dominierte bei Shopping, Finanzen, Wetter und lokalen Fragen, oxylabs lieferte regionale Presse, serp vor allem News. Spätere Daten haben diese Deutung korrigiert: Laut Peec AI ist labrador OpenAIs eigener Suchindex, die übrigen drei sind externe Scraping-Dienste.
Wie viele Suchanfragen stellt ChatGPT im Hintergrund?
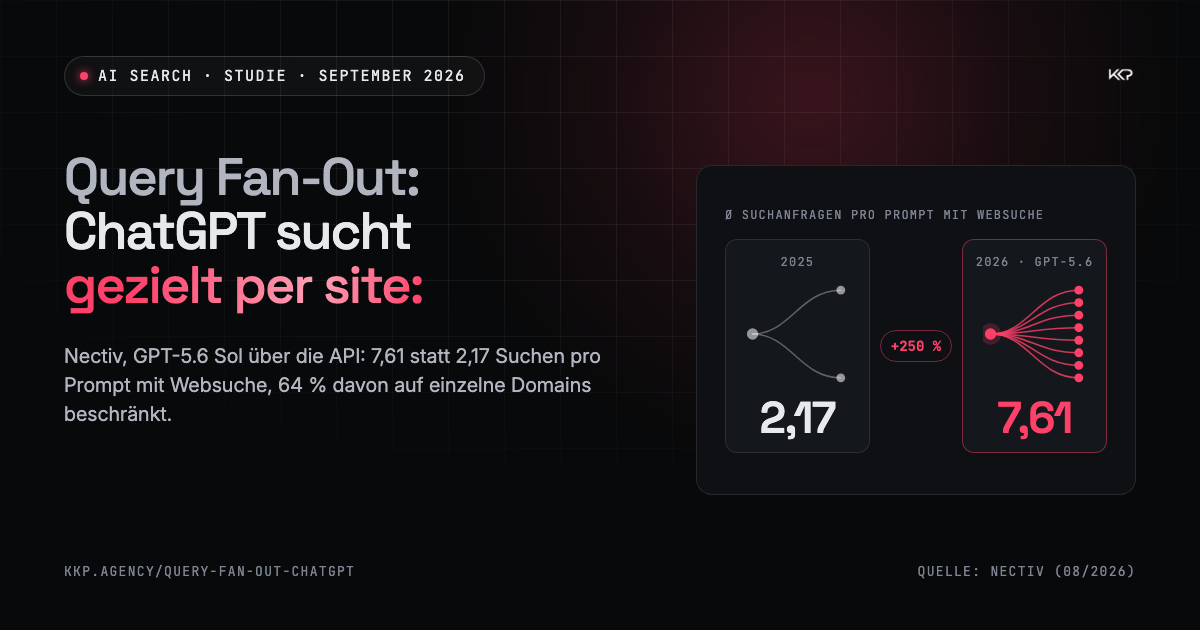
Wie viele Suchanfragen ChatGPT im Hintergrund stellte, hing im Juni vom Modell ab: Das schnelle Modell stellte eine einzige umformulierte Suchanfrage, das Thinking-Modell beim Vergleich mehrerer Produkte 15 bis 40. Die Zahl dieser Fan-Out-Queries richtete sich laut dem Autor nach der Komplexität der Frage. Dass ein Sprachmodell vor der Antwort selbst sucht und die Treffer einliest, ist das Grundprinzip der Retrieval-Augmented Generation (RAG).
- Profound AI search visibility pricing AI engines tracked 2026
- AthenaHQ pricing AI search visibility tool
- site:peec.ai/pricing Peec AI Starter Pro Advanced 50 prompts 150 prompts
- Peec AI pricing $95 $245 $495 official geschätzte Preise
- Scrunch AI pricing stand nicht in der Frage
Geschätzte Preise ließ ChatGPT per Suche bestätigen. Öffnete es eine Preisseite selbst, durchsuchte sein Browsing-Werkzeug den Text wörtlich nach „$“, „€“, „99“ und „Agency“.
Warum ruft ChatGPT Seiten ab, zitiert sie aber nicht?
Jedes Zitat hing an einem bestimmten Satz der Antwort. Die Analyse trennt drei Zustände: abgerufen, zitiert und erwähnt. Am deutlichsten zeigte sich der Unterschied in der Stichprobe bei Reddit und YouTube:
- Abgerufen
- Im Kontext des Modells, für Leser unsichtbar.
- Zitiert
- Fußnote hinter einem bestimmten Satz.
- Erwähnt
- Brand-Name in der Antwort, aber nicht Quelle der Aussage.
Zum Vergleich, anderes Maß: Zitierrate des Quellkanals Reddit 1,93 %, YouTube 0,51 % (Ahrefs, 1,4 Mio. Prompts)
Nach Deutung des Autors kann ChatGPT nur Text zitieren, den es tatsächlich eingelesen hat: Bei YouTube lieferte die Suche nur Titel und Beschreibung, kein Transkript, ein Reddit-Thread dagegen stand vollständig als Text auf der Seite. Bei den Zitaten lag Reddit in der Stichprobe mit 11 knapp vor rtings.com (10), zoho.com (9) sowie semrush.com und techradar.com (je 8).
Vor dem Zitat bündelte ChatGPT außerdem die Ergebnisse pro Domain:
„One strong page per claim beats a pile of weak ones“, schreibt der Autor: Eine starke Seite pro Aussage schlägt einen Stapel schwacher. Der Effekt ähnelt dem Umgang von Suchmaschinen mit Duplicate Content, nur auf Ebene der Antwort.
Wann zitiert ChatGPT die Seite einer Brand und wann Drittquellen?
ChatGPT zitierte die Seite einer Brand für deren eigene Fakten wie Preise und technische Daten, in der Stichprobe etwa bei Zoho, Semrush und mehreren VPN-Anbietern. Das Urteil, welches Produkt das beste ist, holte es von Dritten. Voraussetzung war, dass die Fakten als Text auf der Seite standen. Bei Ahrefs notierte das Thinking-Modell in seiner Begründung, die Preisseite wirke aktueller und sei deshalb zu zitieren („pricing page seems more current, so I should cite that“). Bei zwei anderen Anbietern scheiterte das Lesen:
-
01Preisseite lädt die Zahlen per JavaScriptIm ausgelieferten Text stehen keine Preise.
-
02Das Modell findet keine PreiseEs vermutet JavaScript als Ursache.
-
03Die Begründung plant Drittquellen einZitate von G2 statt von der offiziellen Seite.
- Preisseite Profound
the pricing isn't showing up directly in the search result, possibly because it's loaded with JavaScript
- Preisseite Peec AI
the pricing doesn't show up directly, possibly hidden with JavaScript
- Entscheidung
I can quote third-party sources since the official page is hard to parse and doesn't show prices
use citations from G2 where appropriate
Übersetzt: Die Preise erschienen nicht direkt im Suchergebnis, vermutlich wegen JavaScript. Deshalb könne das Modell Drittquellen wie G2 zitieren, weil die offizielle Seite schwer auszulesen sei. Die Vermutung stimmte: Laut dem Autor luden beide Anbieter ihre Preise per JavaScript nach. Dass Abrufsysteme ohne JavaScript-Ausführung nachgeladene Inhalte nicht sehen, ist aus dem Crawling bekannt.
Was hat sich an ChatGPTs Quellenauswahl seit Juli geändert?
Die Mechanik hat sich bestätigt, die Deutung der Pipelines und die Häufigkeiten nicht. Stand 24. September 2026 zeigen das vier Folgeartikel von Snippet Digital, eine Messung mit knapp 10.000 Läufen und Rohdaten-Auswertungen von Peec AI.
Am 14. Juli nahm der Autor die Lesart von der lizenzierten Publisher-Stufe selbst zurück: Auf einem kostenlosen Konto in Italien trug jede Publisher-Quelle das Label labrador, auch kleine italienische Seiten. Zudem beschrieb er einen fünften Wert bing, der Anfang Juli auf dem Konto eines Forschers von Peec AI in Deutschland auftauchte. Peec AI selbst zählt dagegen nur vier Werte und sieht Bing vor allem in Deep Research. Am 21. Juli löschte OpenAI das Feld result_source, am 4. September deutete Peec AI labrador als OpenAIs eigenen Suchindex:
| Pipeline | Juni · Snippet Digital | September · Peec AI |
|---|---|---|
| labrador | Positivliste etablierter Publisher, gedeutet als lizenzierte Stufe | OpenAIs eigener Index aus 12 themenspezifischen Teilindizes |
| bright | Bright Data: Shopping, Finanzen, Wetter, Local | gescraptes Google Web und Maps |
| oxylabs | Oxylabs: regionale und lokale Presse | gescraptes Google für die News-Vertikale |
| serp | offene Web-Basis, vor allem News | weiterer SERP-Scraper für News und Local |
Welche Pipeline greift, hängt damit auch von Konto, Tarif und Modus ab. Im Nachtest vom 4. Juli liefen auf dem bezahlten Konto des Autors 558 von 595 Quellen der letzten 30 Gespräche über bright, rund 94 % (eigene Rechnung). In einer Messung mit 9.946 über Bright Data erfassten Läufen (veröffentlicht am 5. Juli) war labrador dagegen in 88,1 % der Läufe die Hauptquelle. Über 90 % der Nutzer sind laut Search Engine Land im kostenlosen Tarif, dessen Instant-Modus praktisch nur Labrador nutzt (mehr im Artikel zu ChatGPTs eigenem Suchindex Labrador). Für den bezahlten Pfad zählen also Google-Rankings mit, für die Mehrheit vor allem OpenAIs eigener Index.
So haben sich die übrigen Befunde entwickelt (in Klammern das Veröffentlichungsdatum, ohne andere Angabe von Snippet Digital):
- bestätigtEs gibt Fragen ohne Websuche. Ende Juli lösten 7 von 24 Testfragen ohne das Wort „best“ keine Websuche aus, vor allem Definitionen und How-tos. Bewusst aktuelle Fragen wurden dabei nicht erneut geprüft (10.08.).
- bestätigtAbgerufen ist nicht zitiert. In 57 Gesprächen vom 24./25. Juli zitierte ChatGPT 110 von 3.554 abgerufenen Seiten, 3,1 % (10.08.).
- präzisiertBündelung pro Domain. Seit Juli listet jedes Zitat nicht zitierte Seiten mit derselben Aussage mit auf, auch Schwesterseiten derselben Domain (14.07.). Die Zitierquote lag bei zwei Seiten je Domain am höchsten (6,2 %, bei einer Seite 4,0 %), bei fünf Seiten nur bei 1,9 % (10.08.).
- neuShortlist vor der Suche. In 21 von 27 Gesprächen enthielt schon ChatGPTs erste Suchanfrage Brands, die der Nutzer nie genannt hatte (10.08.).
- geändertFormat der Fan-Out-Queries. Seit einem Umbau zwischen dem 16. und 20. August steht jede Hintergrund-Suche als eigene Zeile mit Typ, Query und Ziel-Domain im Netzwerkverkehr (21.08.).
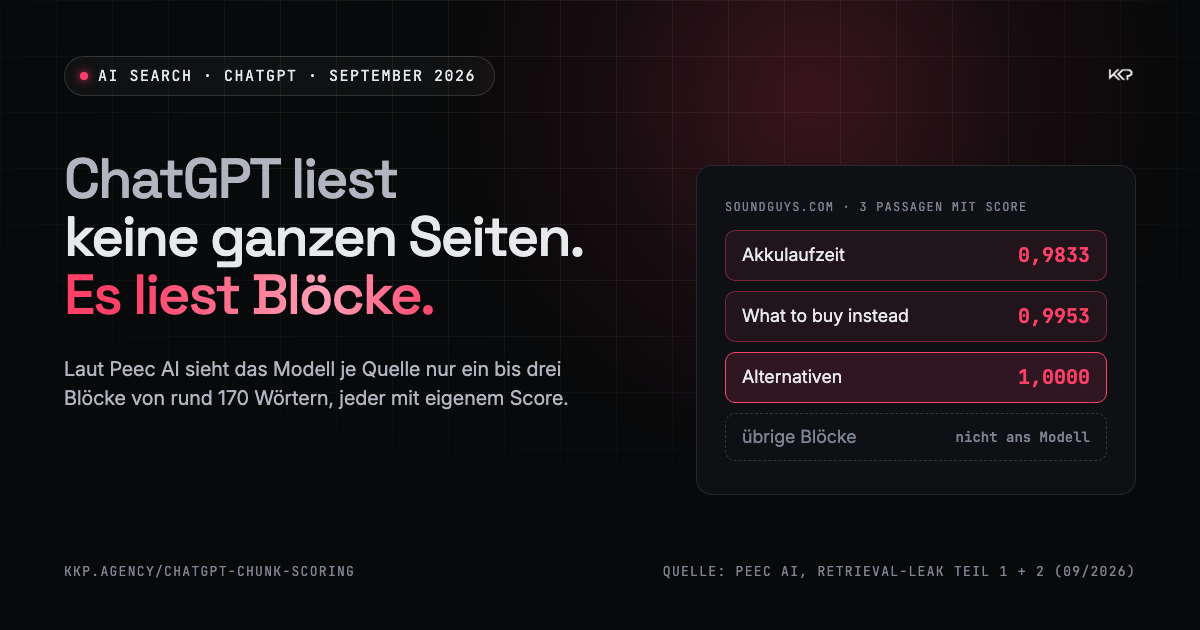
- überholtKein Score sichtbar. Anfang September standen kurzzeitig Scores je Ergebnis und je Textblock von rund 170 Wörtern im Netzwerkverkehr (Peec AI, 07.09.), am 9. September waren sie auf einem Testkonto wieder verschwunden (The GEO Lab, 09.09.). Die Formel bleibt unbekannt.
- nicht haltbarYouTube wird nicht zitiert. Peec AI wertete rund 100 YouTube-Zitate aus etwa 50 Sessions aus. Demnach hat YouTube eine eigene Scoring-Ebene aus Views, Followern und Verifizierung (Peec AI, 15.09.).
- schwankendReddit vorn. In einem Gespräch waren 84 von 221 Einträgen im Abrufpool Reddit-Threads, nur als Snippet, zitiert wurde keiner (21.08.). In einem anderen gingen 6 von 8 Zitaten an Reddit (25.08.). Laut Promptwatch fiel der Reddit-Anteil an ChatGPT-Zitaten Mitte August von 3,83 % auf unter 1 % (über Snippet Digital, 21.08.).
Wie belastbar ist die Netzwerk-Analyse?
Die Struktur ist belastbar, die Häufigkeiten zeigen nur die Richtung. Dass ein Feld existiert, beweist laut Autor ein einziger sauberer Mitschnitt. Alle Häufigkeiten und Rangfolgen der Juni-Analyse stammen dagegen aus einigen Dutzend Suchen auf einem bezahlten Konto mit Standort Dubai, erhoben an zwei Tagen, überwiegend zu SaaS und Tech. Gesundheits- oder Modefragen würden laut Autor andere Domains nach vorn bringen.
Dazu kommt der Tarif: Die Juni-Analyse maß den für OpenAI teureren bezahlten Pfad einer Minderheit, das passt zur Dominanz von bright. Tarif und Land lassen sich in den Vergleichsdaten aber nicht trennen, das kostenlose Konto stand in Italien, das bezahlte in den VAE. Auch 201 zu 0 bei YouTube ist ein Stichprobenbefund: In einer früheren, größeren Messung von Profound mit rund 700.000 Social-Media-Zitaten in ChatGPT (Oktober bis Dezember 2025, US-Englisch) kam YouTube auf 0,99 % aller Zitate.
Der Autor ist Mitgründer von Snippet Digital und des SEO-Tools Keyword Insights, das in seinen Tests als Beispiel auftaucht. Seine Firma nutzt seit Langem Oxylabs, und seit Juli bietet er eine kostenlose Chrome-Erweiterung an, die diese Daten ausliest. Peec AI verkauft selbst AI-Visibility-Tracking. Den eigenen Netzwerkverkehr kann jeder mit den DevTools lesen, die Feldnamen aus dem Juni sind aber verschwunden. Für alle Quellen gilt der Satz des Autors: „The structure holds. The numbers move.“ Die Struktur hält, die Zahlen bewegen sich.
Was heißt das für die Sichtbarkeit deiner Brand in ChatGPT?
Deine Brand braucht zwei Dinge: Fakten als lesbaren Text auf der eigenen Seite und Präsenz in den Drittquellen, die das Urteil liefern. Daraus folgen fünf Hebel, die unabhängig von Feldnamen gelten:
Aus unserer Sicht hat die Juni-Analyse früh die richtige Frage gestellt: nicht, wer in der Antwort steht, sondern wie sie zustande kommt. Die Mechanik hat alle Umbauten bis September 2026 überdauert: einordnen, abrufen, bündeln, wenige Quellen zitieren.
Übertragen auf Brands aus der Finanz- und Versicherungsbranche heißt das nach unserer Einschätzung: Konditionen, Beiträge und Leistungen gehören als HTML-Text auf die offizielle Seite. Vergleichsportale, Fachmedien und Bewertungen wirken auch bei Fragen ohne Websuche, denn sie prägen die Shortlist, die ChatGPT vor der ersten Suche bildet. Welche Drittquellen zählen, ist branchenabhängig: Reddit, in der SaaS-Stichprobe knapp vorn, spielt in der deutschen Finanz- und Versicherungsbranche nach unserer Erfahrung kaum eine Rolle.
Wir bei KKP messen deshalb je Kundenbranche, welche Quellen ChatGPT abruft und zitiert, statt uns auf generische Quellenlisten zu verlassen, und trennen dabei Erwähnung und Empfehlung. Welche Kennzahlen sich dafür eignen, steht im Artikel zu den SEO-KPIs im KI-Zeitalter.
Wie wir das für Brands aus der Finanz- und Versicherungsbranche umsetzen, zeigt unsere AI-Search-Beratung.
FAQ: Häufige Fragen zur Quellenauswahl in ChatGPT
Wie wählt ChatGPT seine Quellen aus?
ChatGPT wählt Quellen in Stufen aus: Es ordnet die Frage einem Typ zu, entscheidet, ob es sucht, holt Ergebnisse über mehrere Abrufwege (Pipelines) und zitiert nur einen kleinen Teil. In 57 Gesprächen vom 24./25. Juli 2026 zitierte es 110 von 3.554 abgerufenen Seiten, 3,1 % (Snippet Digital). Die Seite einer Brand diente in der Juni-Analyse vor allem als Quelle für Fakten wie Preise, das Urteil kam von Dritten.
Woher bezieht ChatGPT seine Informationen?
Aus dem Trainingskorpus oder aus einer Websuche, über die ChatGPT je Frage entscheidet. In der Netzwerk-Analyse von Snippet Digital (06/2026) liefen 3 von 10 bewusst aktuell formulierten Fragen ohne Websuche. Sucht ChatGPT, kommen die Ergebnisse laut Peec AI (09/2026) aus OpenAIs eigenem Suchindex Labrador und von externen Scraping-Diensten, die unter anderem Google abfragen.
Warum ruft ChatGPT meine Seite ab, zitiert sie aber nicht?
Abgerufen heißt nur, dass die Seite im Kontext des Modells liegt. Zitiert wird sie erst, wenn ChatGPT eine Aussage der Antwort an ihren Text bindet, laut Snippet Digital nur an tatsächlich eingelesenen Text. In deren Juni-Stichprobe wurde Reddit 278-mal abgerufen und 11-mal zitiert, YouTube 201-mal abgerufen und kein einziges Mal zitiert. Größere Messungen von Ahrefs und Peec AI zeigen aber, dass ChatGPT YouTube durchaus zitiert.
Kann ChatGPT Preise lesen, die per JavaScript geladen werden?
Nein. Laut einer Analyse auf Search Engine Land (08/2026, 1.200 Antworten) führt ChatGPT beim Lesen von Seiten kein JavaScript aus. In der Netzwerk-Analyse von Snippet Digital (06/2026) fand es bei zwei Anbietern die nachgeladenen Preise nicht und plante Zitate von Drittquellen wie G2 ein. Preise und Konditionen gehören deshalb als HTML-Text auf die Seite.
Was bedeutet Labrador bei ChatGPT?
Labrador war einer von vier regulären Werten im Feld result_source, das ChatGPTs Rohdaten vom 21.05. bis 21.07.2026 zeigten (zeitweise kam bing hinzu). Snippet Digital deutete den Wert im Juni 2026 als lizenzierte Publisher-Stufe und nahm das am 14.07.2026 zurück. Laut Peec AI (04.09.2026) ist Labrador OpenAIs eigener Suchindex aus 12 themenspezifischen Teilindizes.