ChatGPT liest keine ganzen Seiten: Beim Chunking zerlegt es sie in Textblöcke mit eigenem Score, und je Quelle erreichen laut Peec AI nur ein bis drei davon das Modell. Für einen Beispiel-Prompt rief ChatGPT 223 von 228 Suchergebnissen ab und zitierte 16 davon. Grundlage ist eine Debug-Ansicht im Datenstrom der ChatGPT-Oberfläche, ausgewertet im September 2026. Seiten aus OpenAIs eigenem Index bringen ihre Blöcke samt Score schon mit. Für deine Brand zählt deshalb, ob jeder Abschnitt seine Frage allein beantwortet.
Wie wählt ChatGPT seine Quellen aus?
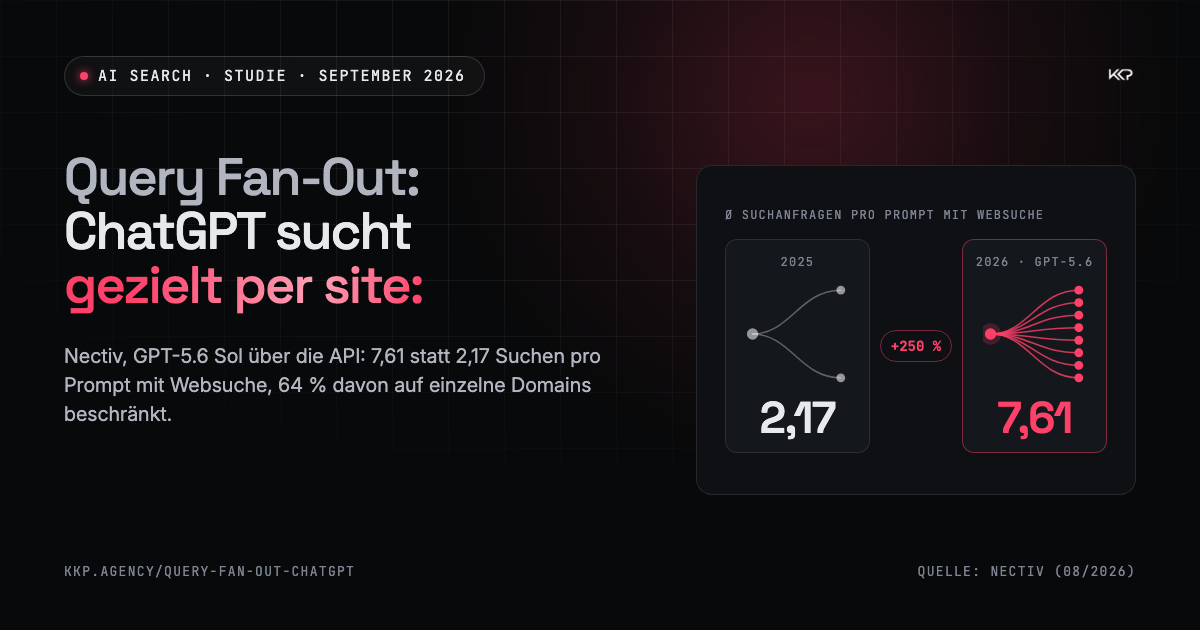
ChatGPT wählt seine Quellen in mehreren Stufen aus, Nutzer sehen nur die letzte: die Zitate. Peec AI, Anbieter von AI-Visibility-Tracking, hat den Prozess im Datenstrom der ChatGPT-Weboberfläche nachvollzogen. Das Team hat dort eine Debug-Ansicht mit 150.000 JSON-Zeilen je Prompt in drei Teilen ausgewertet. Teil 1 verfolgt den Prompt „best AI visibility tools“. Daraus leitete ChatGPT 18 versteckte Queries ab, also Suchanfragen, die das System im Hintergrund selbst formuliert (Fan-Out-Queries):
Fast jedes Ergebnis wurde abgerufen, zitiert wurden 16 von 223 abgerufenen Seiten. Abgerufen heißt dabei nicht live geöffnet: The GEO Lab, ein von Peec AI unabhängiges Forschungsangebot, fand bei 9 von 14 im Datenstrom gemeldeten Abrufen auf eigene Domains keinen passenden Besuch im Server-Log. Die wahrscheinlichste Erklärung laut The GEO Lab: Index oder Cache.
Wie liest ChatGPT eine Webseite, und was ist Chunking?
ChatGPT liest eine Webseite als Markdown-ähnlichen Text und zerlegt ihn in Blöcke. Laut Teil 1 erreicht der Seiteninhalt das Modell nicht als HTML, sondern als Text-Render, also als aus dem HTML erzeugter Text mit Markdown-Zeichen. Überschriften, Listen, Tabellen und Linktexte überleben, Layout und Link-Adressen nicht. Vier geprüfte Formatierungsmerkmale, etwa Tabellentrenner ohne äußere Striche, passen zu einer angepassten Fassung der Python-Bibliothek html2text:
<div class="hero grid-3">
entfällt
<h2>Tools im Vergleich</h2>
## Tools im Vergleich
<li>Listenpunkt</li>
* Listenpunkt
<table class="compare">…
Rank | Tool | Best for | Starting price*
--- | --- | --- | ---
<a href="/preise">Preise</a>
Preise
<button>Demo buchen</button>
[Button: Demo buchen]
<img src="chart.png">
Image
Diesen Render schneidet ChatGPT in Blöcke, im Datenstrom Chunks oder Passagen genannt. Teil 1 nennt rund 170 Wörter je Block: „The model does not see your full page. It sees one to three of those blocks per source.“ Das Prinzip ist aus der Retrieval-Augmented Generation bekannt. Die 170 Wörter sind eine Größenordnung: Die drei dokumentierten Passagen aus Teil 2 stammen von einer Seite aus dem Index und haben 987 bis 1.289 Zeichen. Meta-Tags reisen mit jedem Ergebnis als rohe Liste mit, og:title zum Beispiel bei 187 von 226 Ergebnissen. Genutzt werden sie damit nicht zwingend: Laut Search Engine Land ignoriert ChatGPTs Index die Meta-Description beim Snippet.
Wie bewertet ChatGPT einzelne Textblöcke?
ChatGPT vergibt jedem Block einen eigenen Score. Ihn berechnet laut Teil 2 ein neuronales Ranking-Modell, das im Datenstrom sonic-re-fh-chunk-ev3-sx4 heißt. Teil 2 zeigt das an einem Shopping-Prompt, der nach einem Vergleich dreier Kopfhörer unter 300 Dollar fragt. Für einen Testbericht von soundguys.com speichert der Eintrag im Datenstrom drei Passagen mit je einem Score:
| Passage im Eintrag | roh | normalisiert |
|---|---|---|
| parts[0] · mit Überschrift Akkulaufzeit: XM5 31 h 53 min, Bose 21 h 25 min | 0,9817 | 0,9833 |
| parts[1] · mit Überschrift „What to buy instead“: WH-1000XM4, Bose QuietComfort | 0,9937 | 0,9953 |
| parts[2] · ohne Überschrift Alternativen: Sennheiser Momentum 4, Monoprice, Sony WF-1000XM4 | 0,9984 | 1,0000 |
| Übrige Blöcke der Seite (schematisch) | nicht ans Modell | |
Im Suchergebnis-Eintrag stehen die Roh-Scores, in der Fassung fürs Modell sind sie normalisiert: Der beste Block wird exakt 1,0, die anderen werden mit nahezu demselben Faktor skaliert. Geprüft hat das Team alle 76 Seiten des Prompts aus dem Index. Bei den 8 Treffern der News-Engine darunter liegt der beste Block nur bei 0,5, sie starten mit halbem Gewicht. Warum, bleibt offen.
Bewertet wird jede Passage roh: „Nothing is rewritten. The chunk is scored as it is.“ Beginnt ein Block an einer Überschrift, wird sie mitbewertet. Zwei der drei SoundGuys-Passagen tragen eine, die bestbewertete beginnt mitten im Abschnitt. Eine weitere Spalte mit der Angabe „minhash“ deutet das Team als Deduplizierung, also als Erkennen von Duplicate Content auf Ebene der Passagen.
Ganz aus der Bewertung fällt die Seite aber nicht: Laut Teil 1 enthält der Strom auch einen Score je Ergebnis. Zur Debatte „Seite oder Chunk“ schreibt Peec AI, beide Positionen seien unvollständig. Im August hatte das Team 12 Open-Source-Reranker getestet, Modelle, die Passagen nach Passung zur Anfrage ordnen: Jedes zog eine direkte Antwort einer Produktbeschreibung vor oder setzte beide nahe an den Höchstwert. Neu ist der Beleg aus dem laufenden ChatGPT.
Liest ChatGPT Seiten aus seinem eigenen Index anders als frisch abgerufene?
Ja, laut Teil 2 laufen Seiten aus dem Index und frisch abgerufene Seiten über zwei Pfade. Von 96 abgerufenen Seiten des Shopping-Prompts lagen 76 bereits in Labrador, OpenAIs eigenem Suchindex. Ihre Passagen kommen samt Scores direkt aus dem Index. Die 20 frisch abgerufenen Seiten werden erst zur Laufzeit in hunderte kleine Fragmente zerlegt:
Peec AI nennt das eine mehrstufige, hybride Retrieval-Hierarchie: Index und frischer Abruf laufen nebeneinander. Belegt ist nur die unterschiedliche Verarbeitung, kein Vorteil beim Zitat. Weitere Pfade untersucht das Team noch.
Zählt die Domain bei ChatGPT überhaupt noch?
Ja, die Domain zählt an zwei Stellen: vor dem Chunk-Score und danach. Versteckte Queries können die Suche vorab auf Domains einschränken, etwa auf peec.ai (Teil 1) oder auf rtings.com, tomsguide.com und soundguys.com (Teil 2). Nach dem Chunk-Score sortiert ChatGPT laut Teil 1 im Reasoning, der Denkphase kurz vor der Antwort, die Domains ein zweites Mal. Die Abfolge unten ist aus den Feldern des Datenstroms rekonstruiert, eine feste Reihenfolge beschreibt Peec AI nicht:
-
01Retrieval18 versteckte Queries, je mit vermerkter Engine, einzelne auf Domains eingeschränkt.
-
02should_fetchAbruf-Entscheidung je Ergebnis, mit Crawl- und Publikationsdatum.
-
03Chunk-ScoreEin Score je Block, nur die besten gelangen in den Kontext des Modells.
-
04ReasoningZweiter Ranking-Durchgang: Die Domains werden neu sortiert.
-
05AntwortWort-Budget je Quelle im Modell-Prompt, 16 Zitate sichtbar.
Gewichte für den zweiten Durchgang zeigt der Datenstrom nicht. Ob dort nur Domains ankommen, deren Blöcke das Chunk-Scoring überstanden haben, ist ebenfalls nicht belegt.
Wie bewertet ChatGPT YouTube-Videos?
Bei YouTube-Videos fließt laut Teil 3 (15.09.2026) eine eigene Popularitätsebene in den Score ein, die kein anderer Quellentyp hat. Rekonstruiert aus rund 50 Sessions mit etwa 100 YouTube-Zitaten sind es 14 Zusatzsignale, jedes ein fester Bonus ab einer Schwelle: 1.001 Views bringen denselben Bonus wie 9.999.
Die größten Posten sind die Stufen „über 1.000 Follower“ (16 % aller Boni) und „über 10 Mio. Views“ (17 %). Die hohen Stufen wurden gezielt mit großen Kanälen befüllt, Zählungen je Stufe fehlen. The GEO Lab weist darauf hin, dass der Zuschlag über 100 Mio. Views kleiner ist als der über 10 Mio. Weil sich die Boni addieren, wiegen die View-Boni ab 100 Mio. kumuliert trotzdem fast doppelt so viel wie die Follower-Boni.
Wie belastbar sind die Daten aus dem Leak?
Die Richtung ist belastbar, die Nachkommastellen sind es nicht. Die Daten sind eine Momentaufnahme eines Systems, das laufend umgebaut wird. Peec AI schreibt selbst: „Everything can change tomorrow or next month.“
- Datenquelle
- ChatGPT-Weboberfläche, nicht die API.
- Konfiguration
- A/B-Varianten, Modellwahl und Denkstufe (Instant, Medium, High) ändern die Retrieval-Konfiguration.
- Stichprobe
- Funnel: 1 Prompt. Chunks: 76 von 96 Seiten eines Prompts. YouTube: etwa 50 Sessions.
- Auswertung
- 150.000 bis über 200.000 JSON-Zeilen je Prompt, von Hand gelesen.
- Messfenster
- Ab 09.09.2026 zeigte das Testkonto von The GEO Lab keine Chunk-Scores mehr. Ob alle Konten betroffen sind, ist offen.
Für die Mechanik spricht die konsistente Normalisierung auf allen 76 geprüften Seiten, allerdings innerhalb einer Quelle und eines Prompts. The GEO Lab hat am 08.09.2026 in 20 Läufen auf einem ChatGPT-Plus-Konto bestätigt, dass der Strom Retrieval-Daten und Chunk-Scores enthielt. Gezählt wurde nur, was aus OpenAIs IP-Bereichen kam. Zwei Anfragen gaben sich per User-Agent als ChatGPT aus und stammten von fremden Servern. Eine unabhängige Nachmessung der Chunk-Scores gibt es nicht, für Häufigkeiten reicht keine Stichprobe.
Gegen genaue Werte sprechen drei Punkte. Die Prompts sind englisch und im US-Kontext abgesetzt, Kontotyp und Modus nennt Peec AI nicht. Der Normalisierungsfaktor driftet in der sechsten Nachkommastelle. Und Teil 1 nennt 228 Ergebnisse im Text, 226 in der Bildunterschrift. Keine Quelle ist neutral: Peec AI verkauft AI-Visibility-Tracking, The GEO Lab bietet eine kostenlose Browser-Erweiterung an, und wir bei KKP beraten zu diesem Thema.
Wie optimierst du Inhalte für das Chunking in ChatGPT?
Für das Chunking optimierst du, indem jeder Abschnitt als einzelner Block verständlich ist, schon ab dem ersten Satz nach der Überschrift. Sechs Hebel folgen aus der Mechanik:
Googles Leitfaden zu generativen KI-Funktionen sagt, für Google Search müsse man Inhalte nicht in kleine Stücke zerlegen. Die Hebel verlangen das auch nicht. Sie setzen auf semantisches HTML, das Google ebenfalls empfiehlt: Abschnitte, die für sich stehen, mit echten Überschriften, Listen und Tabellen. Markdown-Dateien oder eine llms.txt, eine Übersichtsdatei für Sprachmodelle, braucht es nicht.
Blöcke oder Domain: Wo setzt Optimierung für ChatGPT an?
Optimierung für ChatGPT setzt aus unserer Sicht an Block und Domain an, und beide wirken in Reihe: Domain-Filter in den Queries, Chunk-Score, Neusortierung im Reasoning. Der Index-Status bestimmt zudem, wie die Blöcke einer Seite gelesen werden. Dass er einen schwachen Block aufwertet, zeigen die Daten nicht. Eine starke Domain ohne passenden Block hat es nach unserer Lesart schwer.
Unser Artikel zu Labrador endete beim Abruf. Der Datenstrom zeigt den nächsten Schritt: Im Index zu sein verändert, wie eine Seite gelesen wird, nicht nur, ob. Aus Seitenoptimierung wird Abschnittsoptimierung.
Dass Template-Bausteine wie Teaser-Boxen mit dem Inhalt konkurrieren können, deutet eine eigene Embedding-Messung an, also ein Vergleich von Bedeutungsvektoren, an einer Seite einer Bank-Website, die wir betreuen. Bei 4 von 9 Fan-Out-Queries lag dort der Teaser „Weitere interessante Inhalte“ näher an der Query als der Seiteninhalt. Die 9 Queries stammen aus 4 Durchläufen eines KI-Anbieters an einem Tag, abgerufen per API. Das zeigt eine Richtung, keinen Effekt von ChatGPTs Ranking-Modell. Chunk-Kannibalisierung, also ein Nebenblock, der den Inhaltsblock verdrängt, ist für uns trotzdem ein Template-Thema: Lösen lässt sie sich im Seitenaufbau, nicht im Text.
Bei YouTube zählen Kanalgröße und Verifizierung messbar, aber begrenzt. Ein Zitat tragen sie allein nicht. Sichtbarkeit messen wir über die ChatGPT-Oberfläche mit sauberen Konten ohne Memory, also ohne gespeicherten Nutzerkontext, und erfassen Abruf, Block und Zitat getrennt. Eine dauerhafte KPI bauen wir auf einem Leak nicht auf.
Wie wir das für Brands aus der Finanz- und Versicherungsbranche umsetzen, zeigt unsere AI-Search-Beratung.
FAQ: Häufige Fragen zum Chunking in ChatGPT
Was ist Chunking bei ChatGPT?
Chunking heißt, dass ChatGPT eine Seite nicht ganz liest, sondern in Textblöcke zerlegt, die ein neuronales Ranking-Modell einzeln bewertet. Laut Peec AI (09/2026) bringen Seiten aus OpenAIs eigenem Index Passagen von rund 170 Wörtern samt Score mit, frische Seiten werden erst zur Laufzeit zerlegt. Das Modell sieht davon ein bis drei Blöcke je Quelle.
Muss ich Inhalte für ChatGPT in Chunks aufteilen, obwohl Google das für unnötig hält?
Zerstückeln musst du nichts. Google schreibt im Leitfaden zu generativen KI-Funktionen (Stand 10.07.2026), für Google Search müsse man Inhalte nicht in kleine Stücke zerlegen. Laut Peec AI (09/2026) bewertet ChatGPT Textblöcke einzeln. Beides passt, wenn jeder Abschnitt eine echte Überschrift trägt und seine Frage allein beantwortet.
Wie lang sollte ein Abschnitt für ChatGPT sein?
Eine feste Länge gibt es nicht. Peec AI (09/2026) nennt rund 170 Wörter je Block als Größenordnung, die drei dokumentierten Passagen haben 987 bis 1.289 Zeichen. Weil Blockgrenzen nicht immer an Überschriften liegen, sollte schon der erste Satz eines Abschnitts die Frage beantworten.
Wie verlässlich ist der ChatGPT-Leak von Peec AI?
Die Richtung ist belastbar, genaue Werte sind es nicht. Die Normalisierung war auf allen 76 geprüften Seiten eines Prompts konsistent, und The GEO Lab hat mit eigenen Server-Logs bestätigt, dass der Datenstrom Chunk-Scores enthielt. Eine unabhängige Nachmessung der Scores fehlt, und laut Peec AI (09/2026) kann sich das System jederzeit ändern.