Ein Promptset für AI Search misst nur dann den Markt, wenn jeder Prompt einen Beleg aus echten Daten trägt. In einem geprüften Bestandsset waren nur 68 von 288 Prompts (24 %) kaufnah, und 10 von 17 relevanten Wettbewerbern fehlten im Tracking. Visibility, Share of Voice und Sentiment im Prompt-Tracking hängen davon ab, welche Fragen im Set stehen. KKP erstellt Promptsets deshalb in neun Schritten aus drei Quellen: Suchdaten, beobachteten Chat-Prompts aus sechs KI-Systemen (laut Sistrix) und Query-Fan-Outs, also den Teilsuchen (Sub-Queries) der Modelle. Für dich heißt das: erst das Set prüfen, dann den Zahlen zur KI-Sichtbarkeit trauen.
Warum entscheidet das Promptset über jede Kennzahl im AI-Visibility-Tracking?
Weil ein Tracking-Tool nur misst, was man ihm vorgibt. Ein Promptset ist die Liste der Prompts, mit der ein Tool wie Peec AI die KI-Sichtbarkeit einer Brand misst: Es schickt die hinterlegten Prompts regelmäßig an KI-Systeme und zählt, welche Brands in den Antworten vorkommen. Daraus entstehen Visibility (wie oft die Brand auftaucht), Share of Voice (ihr Anteil an den Nennungen gegenüber Wettbewerbern) und Sentiment (der Ton der Nennung). Wie diese Kennzahlen ins Reporting passen, steht im Artikel zu den SEO-KPIs im KI-Zeitalter.
Für Keywords gibt es eine Nachfragezahl, das Suchvolumen. Für Prompts nicht: Kein KI-Anbieter veröffentlicht, was Nutzer fragen. Deshalb steht im Vorgehen von KKP eine Regel über allen Schritten: Ein Prompt ohne Beleg ist ein erfundener Prompt und kommt nicht ins Set. Als Beleg zählen vier Herkunftsarten: Suchdaten mit Suchvolumen, eine Formulierung, die Sistrix als Nutzerprompt eines KI-Systems ausweist, beides zusammen als stärkstes Signal und, als letzter Ausweg, Sub-Queries, die ein Modell beim Antworten selbst absetzt.
Wie erstellt man ein Promptset für AI Search?
In neun festen Schritten, an deren Ende jeder Prompt einen Beleg trägt. Die Routinearbeit übernimmt ein KI-Agent: Er ruft Daten ab, clustert Fragen, belegt jeden Prompt und bereitet das Set für das Tracking-Tool vor. Die Datendienste spricht er direkt an: DataForSEO per API, Sistrix und Peec AI über MCP, das Model Context Protocol, einen offenen Standard für den Zugriff von Agenten.
- Topics definieren: echte Produkte und ihre suchtypischen Synonyme, etwa „Tierkrankenversicherung Hund“ zur Hundekrankenversicherung. Keine Wunschthemen.
- Keyword-Basis aufbauen: über DataForSEO, mit Suchvolumen, ohne Brand-Keywords.
- Query-Fan-Outs auslesen: die Sub-Queries von ChatGPT und Gemini.
- Beobachtete Prompts ziehen: über Sistrix Prompt Research, das Nutzerprompts für sechs KI-Systeme ausweist.
- Intent-Familien clustern: Fragen je Thema nach Absicht bündeln.
- Gewinner-Prompt wählen: je Familie einer, nach fester Rangfolge.
- Topics und Tags vergeben: feste Wertelisten, genau ein Topic je Prompt.
- Yield prüfen: vorab messen, ob kaufnahe Prompts überhaupt Anbieter hervorbringen.
- Workspace aufbauen: Topics, Tags, Wettbewerber und Prompts im Tracking-Tool anlegen.
Welche Datenquellen liefern belegte Prompts?
Drei Quellen, die sich ergänzen: Suchdaten zeigen die Nachfrage bei Google, Query-Fan-Outs zeigen, wonach die Modelle selbst suchen, und beobachtete Prompts zeigen, wie Menschen KI-Systeme fragen.
Suchdaten: die Keyword-Basis
DataForSEO liefert je Ausgangsbegriff vier Listen, jeweils mit Suchvolumen, soweit vorhanden: Keyword Suggestions (Begriffe, die ihn enthalten), Keyword Ideas (Begriffe aus derselben Kategorie), Related Keywords aus Googles „Ähnliche Suchanfragen“ und People Also Ask, die Google-Box „Ähnliche Fragen“. Related Keywords allein bringt laut DataForSEO bis zu 4.680 Ideen je Ausgangsbegriff. Diese Daten zeigen, welche Keywords bei Google Nachfrage haben, aber nicht, wie oft eine Frage in ChatGPT gestellt wird.
Query-Fan-Outs: wonach die Modelle suchen
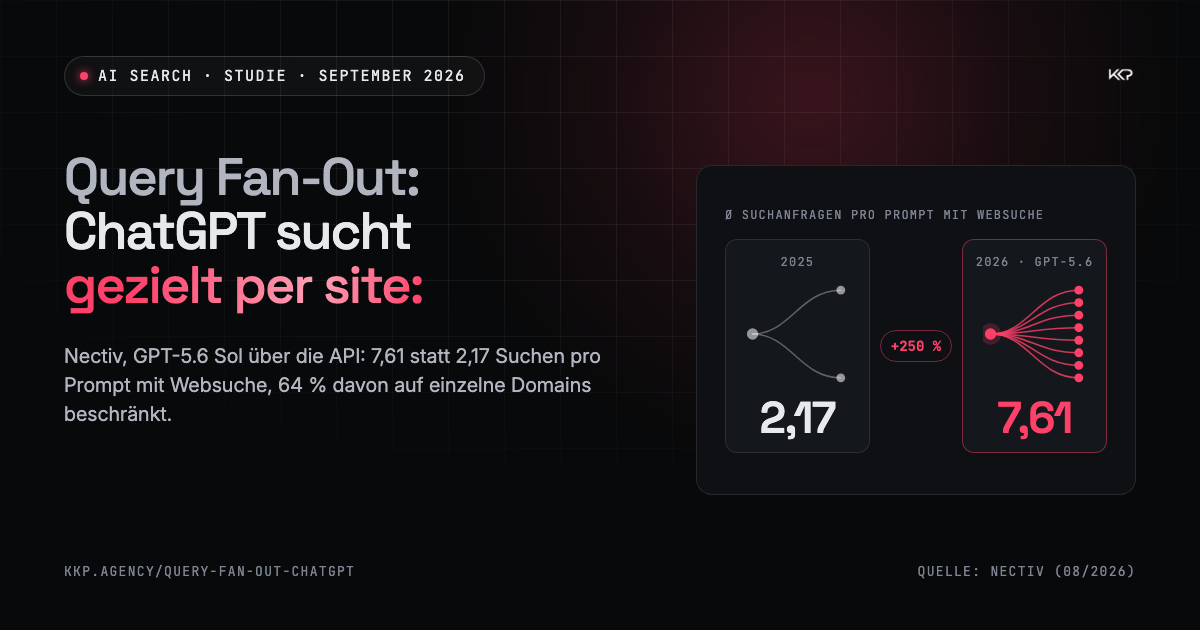
Beim Query-Fan-Out zerlegt ein KI-System eine Frage in Teilfragen und setzt zu jeder eine eigene Suche ab. Google hat die Technik mit dem Start von AI Mode im März 2025 beschrieben. Diese Sub-Queries lassen sich auslesen: Datenanbieter wie DataForSEO geben sie über die Modell-Schnittstelle (API) als eigenes Feld aus, für ChatGPT ebenso wie für Gemini mit Websuche. Es sind echte Suchanfragen der Modelle, keine simulierten. Beispiele aus einem KKP-Testlauf zur Hundeversicherung vom 6. August 2026:
- ChatGPTbeste Hundekrankenversicherung 2026 Vergleich Stiftung Warentest Hundekrankenversicherung
- ChatGPTFinanztip Hundekrankenversicherung Hunde OP Versicherung Vergleich
- ChatGPTCheck24 Hundekrankenversicherung Vergleich Testsieger 2026
- Geminihundekrankenversicherung testsieger finanztest
- Geminibeste hundekrankenversicherung 2025 2026 test
Beide Modelle ergänzen eine Jahreszahl und suchen nach Tests und Vergleichen, teils mit Portalnamen. Die Namen stammen aus dem Modell, nicht von KKP, zeigen aber, welche Aspekte einer Frage die Modelle für relevant halten. Sub-Queries gibt es nur, wenn ein Modell sucht: Im selben API-Test suchte ChatGPT bei 24 von 30 Ausgangsbegriffen, Gemini bei 26 von 30. Das reine Keyword „hundekrankenversicherung“ löste in diesem Lauf bei keinem der beiden Modelle eine Suche aus.
Beobachtete Prompts: wie Menschen fragen
Sistrix Prompt Research weist Nutzerprompts getrennt nach AI Mode, ChatGPT, AI Overviews, Gemini, Copilot und Perplexity aus. Die Datenbasis umfasst laut Sistrix über 62 Millionen echte Nutzerfragen aus der Google-Suche und weiteren Quellen. Seit Juli 2026 ist das Modul auch per MCP abrufbar.
- AI Mode
Lohnt sich eine Hundekrankenversicherung für Welpen
- ChatGPT
Wie finde ich heraus ob meine Vorerkrankung versichert ist
- Gemini
Übernimmt die Versicherung auch Zahnreinigung beim Hund
- Perplexity
abdeckung von rassespezifischen krankheiten wie ivdd
- Copilot
Welche Tierversicherung empfiehlt Stiftung Warentest für Hunde
- AI Overviews
Hunde-OP-Versicherung Vorerkrankungen abgedeckt
Laut Sistrix sind die Prompts für AI Overviews kurz und keyword-artig, die für ChatGPT ausführlicher. Im KKP-Vorgehen übernehmen beobachtete Prompts und Sub-Queries nicht das Suchvolumen ihres Themas. Sonst läge bei der Auswahl jeder Prompt aus einem volumenstarken Thema vor jedem echten Longtail.
Welche Prompts sollte man tracken, wenn nicht die volumenstärksten?
Je Absicht einen. Hinter einem Thema stecken meist mehrere Kaufabsichten, und eine Sortierung nach Volumen misst nur die lauteste. Fragen und Longtails werden deshalb je Thema zu Intent-Familien gebündelt, also zu Gruppen mit derselben Absicht. Je Familie kommt genau ein Prompt ins Set.
- Günstig
- Kosten
- Testsieger
- Leistung
- Anbieter
- Erfahrungen
- Vergleich
- weitere
- 1Beobachtete Formulierungvon Sistrix je KI-System ausgewiesen✓ ins Set
- 2Echte Frageaus Suchdaten oder People Also AskFallback
- 3Longtail-Keywordnur in Frageform gebrachtFallback
Den Gewinner bestimmt die Rangfolge, nicht der Geschmack, und ausgeschmückt wird nichts. Fehlt eine wörtliche Frage, bringt der Agent den stärksten Longtail nur in Frageform: Aus „hunde op versicherung ohne wartezeit“ wird „Welche Hunde-OP-Versicherung gibt es ohne Wartezeit?“. Besteht eine Familie allein aus Sub-Queries, dient eine davon nach derselben Regel als Vorlage. Die Größe des Sets folgt aus den relevanten Familien, aufgefüllt wird nicht.
Wie strukturiert man Topics und Tags im Tracking?
Topics bilden Produkte oder Dienstleistungen ab, Tags alle weiteren Merkmale. Für beide gilt ein geschlossenes Vokabular, also eine feste Liste erlaubter Werte. In Peec AI gehört jeder Prompt zu genau einem Topic. Dient ein Topic dagegen als Filter-Label, etwa für einen Inhaltstyp oder einen Tracking-Zweck, belegt es diesen einzigen Platz. Der Prompt fehlt dann in der Auswertung je Produkt.
Intent und Branding vergibt Peec AI automatisch. Diese Tags werden nicht doppelt angelegt.
Sammel-Labels wie „Sonstiges“ gibt es nicht, sonst ist keine Auswertung mehr trennscharf. Intent (commercial, informational, transactional) und Branding (branded, non-branded) vergibt Peec AI automatisch an jeden Prompt. Eigene Tags gibt es nur für Merkmale, die das Tool nicht kennt, etwa Zielgruppe oder Journey-Phase. Die Automatik wird trotzdem gegengelesen, weil sie Prompts falsch einstufen kann.
Soll man Prompts tracken, bei denen die KI keine Anbieter nennt?
Ja, aber gekennzeichnet. Info-Prompts, also Wissensfragen ohne Kaufbezug, messen Reichweite und Themenführung, keine Kaufentscheidungen. Vor dem Tracking misst das Yield-Gate die Ausbeute eines Prompts: ob die Antwort überhaupt Anbieternamen enthält. Standardmäßig durchlaufen die kaufnahen Prompts das Gate, auf Wunsch das gesamte Set, jeweils in ChatGPT und Gemini. Nennt der erste Durchlauf keinen Anbieter, folgt ein zweiter, weil Antworten schwanken. Das Ergebnis steht als Kennzeichnung am Prompt, aussortiert wird nichts.
- Durchlauf 1ChatGPT und Gemini
- kein Anbieter?Durchlauf 2
- Ergebnisam Prompt gekennzeichnet
Info-Prompts tragen ihre Einstufung als Reichweiten-Prompt. Ihr Yield wird nur gemessen, wenn das ganze Set durch das Gate läuft. So wird eine niedrige Visibility bei einem Info-Prompt nicht als Schwäche der Brand gelesen. Peec AI rät in seiner Dokumentation, Info-Prompts um Brand-Kontext zu ergänzen. Das KKP-Vorgehen lässt die beobachtete Formulierung unverändert und kennzeichnet stattdessen, wofür sie steht.
Im letzten Schritt kommen Topics, Tags, Wettbewerber und Prompts ins Tracking-Tool. Über den Peec MCP kann der Agent sie selbst anlegen, laut Peec-Dokumentation in Stapeln von bis zu 50 Einträgen und ohne CSV-Handimport.
Wie prüft man ein bestehendes Promptset?
Mit denselben Regeln wie ein neues Set: Herkunft je Prompt, Topics als Produktsparten, Intent-Familien und eine Wettbewerberliste aus Daten. Wie groß die Lücken sein können, zeigt ein Bestandsset mit 288 aktiven Prompts, das KKP im August 2026 bei einem Neukunden geprüft hat:
Keines der vier Topics bildete eine Produktsparte ab: Drei waren reine Filter-Labels, das vierte bündelte die Brand-Prompts. Nur 68 der 288 Prompts waren kaufnah, also auf eine Produkt- oder Anbieterentscheidung gerichtet. Maßstab war die Einstufung „commercial“, die KKP je Prompt selbst vorgenommen hat, nicht die automatische Einstufung durch Peec AI. Von den 17 Brands, die in der Sistrix-Themenanalyse dieses Marktes vorn liegen, fehlten 10 im Tracking: 9 ganz, 1 war unter einem anderen Namen hinterlegt und brauchte nur einen Alias. Fehlen Wettbewerber, fehlen auch ihre Nennungen in der Rechnung, und der Share of Voice der eigenen Brand fällt zu hoch aus.
Beim Umbau werden ersetzte Prompts archiviert, nicht gelöscht, damit die Messhistorie erhalten bleibt.
Peec AI bietet mit dem „Prompt Set Grader“ eine eigene Prüfung: Er benotet ein Set von A bis F, etwa nach Topic-Balance, Tag-Hygiene, Funnel-Abdeckung und Dubletten. Die Herkunft der Prompts prüft er nicht.
Wie belastbar ist das Vorgehen?
Die Methode ist dokumentiert, aber nicht extern validiert, und die Befunde zum Bestandsset stammen aus einem einzigen Workspace.
- Praxisbericht, keine Studie. Das geprüfte Set ist ein Einzelfall aus dem Versicherungsumfeld. Die Methode ist übertragbar, die Zahlen sind es nicht.
- Keine offiziellen Prompt-Daten. Beobachtete Prompts stammen aus Drittdaten, und wie Sistrix sie je Plattform erhebt, legt der Anbieter nicht im Detail offen. Das Suchvolumen, das Sistrix zu den Prompts ausweist, ist laut Sistrix ein geschätzter Markt-Indikator, und Google-Suchvolumen ist kein Prompt-Volumen.
- Sub-Queries kommen aus der API. Sie werden über die Modell-Schnittstelle ausgelesen, weil die Chat-Oberflächen sie kaum ausgeben, und schwanken mit Modellversion und Modus. Sie sind Strukturmaterial für die Intent-Familien, kein Abbild der App.
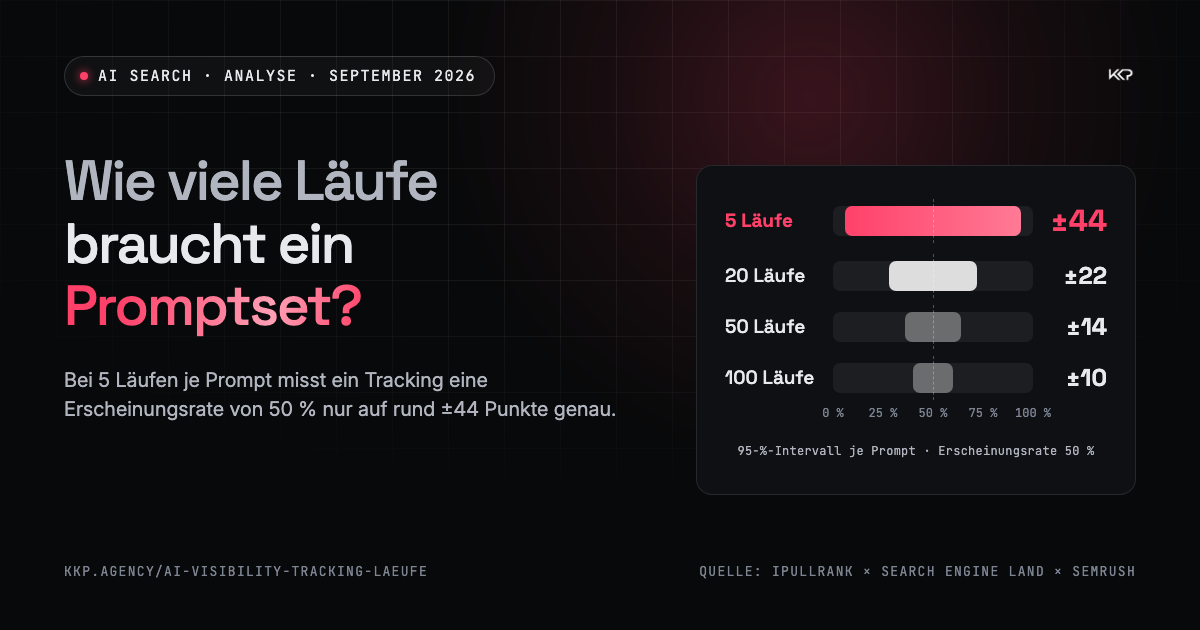
- Das Yield-Gate ist ein Screening. KI-Antworten streuen stark: Laut SparkToro (2.961 Prompt-Läufe in ChatGPT, Claude und Google AI) liefert derselbe Prompt in ChatGPT und Google AI fast nie zweimal dieselbe Brand-Liste, die Chance liegt unter 1 zu 100. Claude ist nur geringfügig konstanter. Belastbare Visibility-Werte entstehen erst im laufenden Tracking über viele Läufe.
- Interessenlage. KKP verkauft AI-Search-Beratung und beschreibt hier die eigene Methode im Stand des LinkedIn-Carousels vom 16.09.2026. KKP nutzt die genannten Tools, der Artikel ist kein Tool-Vergleich.
Was heißt das für dein eigenes Promptset?
Acht Kriterien gelten für neue und laufende Sets, unabhängig vom Tool:
Aus meiner Sicht ist das Promptset das eigentliche Messinstrument des AI-Search-Trackings. Wer die Fragen erfindet, misst am Ende nur, wie gut er geraten hat. Beim Keyword-Set korrigiert das Suchvolumen falsche Annahmen, beim Promptset fehlt dieses Korrektiv, solange kein KI-Anbieter Prompt-Daten veröffentlicht. Das dürfte sich über das Werbegeschäft ändern, weil Werbetreibende sehen wollen, wonach gefragt wird.
Das Set ist deshalb wichtiger als die Wahl des Tools: Das Tool misst zuverlässig, was man ihm vorgibt, die Qualität der Vorgabe liegt beim Set. Auch ein sauberes Set misst allerdings zuerst Nennungen. Ob die KI die Brand empfiehlt oder den Wettbewerber, ist damit noch nicht beantwortet. Wie wir das für Brands aus der Finanz- und Versicherungsbranche umsetzen, steht auf der Seite zu unserer AI-Search-Beratung.
FAQ: Häufige Fragen zu Promptsets für AI Search
Wie erstelle ich ein Promptset für AI-Visibility-Tracking?
KKP erstellt Promptsets in neun Schritten aus echten Daten. Die Topics folgen den tatsächlichen Produkten, dazu kommen eine Keyword-Basis mit Suchvolumen, Query-Fan-Outs von ChatGPT und Gemini und die Nutzerprompts, die Sistrix für sechs KI-Systeme ausweist. Danach folgen Intent-Familien mit je einem Gewinner-Prompt, Tags, eine Vorab-Prüfung auf Anbieternennungen (Yield-Gate) und das Anlegen im Tracking-Tool. Jeder Prompt trägt einen Herkunftsbeleg.
Woher bekomme ich für die Prompt-Recherche echte Prompts, wenn ChatGPT keine Prompt-Daten veröffentlicht?
Die wichtigste Ersatzquelle sind beobachtete Nutzerprompts aus Drittdaten. Sistrix Prompt Research weist Prompts für sechs KI-Systeme aus und nennt als Datenbasis über 62 Millionen echte Nutzerfragen aus der Google-Suche und weiteren Quellen; wie die Prompts je Plattform erhoben werden, legt Sistrix nicht im Detail offen. Query-Fan-Outs ergänzen das als Strukturmaterial: Sie zeigen, wonach die Modelle suchen, nicht was Nutzer fragen.
Wie viele Prompts braucht ein Promptset?
Eine feste Zielzahl gibt es nicht: Die Größe folgt aus den relevanten Intent-Familien, je Familie kommt ein Prompt ins Set, aufgefüllt wird nicht. Mehr Prompts sind nicht automatisch besser: In einem von KKP im August 2026 geprüften Bestandsset mit 288 aktiven Prompts waren nur 68 kaufnah (24 %). Entscheidend ist, dass jede relevante Kaufabsicht mit einem belegten Prompt vertreten ist.
Sollte ich Prompts nach Suchvolumen auswählen?
Nein, denn hinter einem Thema stecken meist mehrere Absichten, etwa Kosten, Testsieger oder Erfahrungen, und eine Sortierung nach Volumen misst nur die lauteste. Suchvolumen ist zudem Google-Nachfrage, kein Prompt-Volumen. KKP bündelt Fragen deshalb zu Intent-Familien und wählt je Familie einen Prompt: eine Formulierung, die Sistrix für eines von sechs KI-Systemen ausweist, vor einer echten Frage aus Suchdaten vor einem Longtail.
Soll ich informationelle Prompts tracken, wenn die KI dabei keine Brands nennt?
Info-Prompts gehören ins Set, aber als Reichweiten-Prompts gekennzeichnet, weil sie Themenführung messen und keine Kaufentscheidungen. Bei KKP laufen standardmäßig die kaufnahen Prompts vorab bis zu zweimal durch ChatGPT und Gemini; ob dabei Anbieter genannt werden, steht danach am Prompt, gelöscht wird keiner. Info-Prompts misst diese Prüfung nur, wenn das ganze Set durchläuft. Belastbare Visibility-Werte entstehen erst im laufenden Tracking, denn laut SparkToro (2.961 Prompt-Läufe) liefern ChatGPT und Google AI fast nie zweimal dieselbe Brand-Liste.
Wie prüfe ich ein bestehendes Promptset, ohne die Messhistorie zu verlieren?
Ein bestehendes Set wird nach denselben Regeln geprüft wie ein neues: Herkunft je Prompt, Topics als Produktsparten, Intent-Familien und Wettbewerber aus Daten. In einem von KKP im August 2026 geprüften Set bildete keines der vier Topics eine Produktsparte ab, und 10 von 17 relevanten Wettbewerbern fehlten im Tracking. Ersetzte Prompts werden archiviert statt gelöscht, damit die Messhistorie erhalten bleibt.